Cloudflare chroni tylko wtedy, gdy go odpowiednio ustawisz
Samo włączenie Cloudflare nie zatrzyma crawlerów AI. Jak dopasować ustawienia do hostingu, płatności i integracji bez utraty ruchu z Google.
Ten scenariusz powtarza się często. Sklep zaczyna działać wolno, firma hostingowa wskazuje na nadmierny ruch, ktoś włącza Cloudflare z poziomu panelu hostingu, domena zostaje przepięta i sprawa wydaje się zamknięta. Po tygodniu obciążenie serwera jest takie samo jak wcześniej, a do tego pojawiają się nowe problemy: płatności zwracają błędy, zmiany na stronie nie są widoczne, któraś integracja przestaje pobierać dane, a spamu w skrzynkach pocztowych jest jeszcze więcej.
Cloudflare nie jest tu winny. Usługa działa według ustawień domyślnych i nie wie, które części sklepu są kosztowne, których robotów sklep potrzebuje ani jak wygląda zwykły klient. Tę wiedzę trzeba wpisać w konfigurację, która zależy od sklepu i usług, z którymi współpracuje, a potem dostosowywać ją do tego, co dzieje się z ruchem.
Co daje samo włączenie Cloudflare
Po przepięciu domeny Cloudflare pośredniczy w ruchu do sklepu. Przyspiesza dostarczanie obrazów i w ten sposób odciąża serwer od odpowiedzi na plików statyczne, a także ukrywa jego adres IP i pochłania najprostsze ataki na poziomie sieci. Nie obejmuje jednak ruchu, który z zewnątrz wygląda jak zwykłe odwiedziny. Crawler pobierający tysiące stron produktów albo program sprawdzający ceny co kilka minut przechodzi przez Cloudflare do serwera tak samo jak klient.
Jeśli sklep nie jest na to przygotowany, efekt bywa wręcz odwrotny. Formularze bez zabezpieczenia w rodzaju CAPTCHA albo Cloudflare Turnstile zaczynają przyciągać więcej spamu. Rośnie też podejrzany ruch, bo zmiany w rekordach DNS są rejestrowane i śledzone przez zewnętrzne serwisy, a ochrona skonfigurowana do połowy jest łatwym celem dla scraperów i botów nadużywających formularzy. Obciążenie zmienia dopiero konfiguracja: reguły zapory, limity zapytań i ustawienia pamięci podręcznej dobrane do konkretnego sklepu.
Nie każdy ruch automatyczny jest szkodliwy
Słowo „bot” kojarzy się z czymś, co trzeba zablokować, ale część ruchu automatycznego jest sklepowi niezbędna, a zablokowanie robotów wyszukiwarek może obniżyć ruch organiczny. Googlebot i Bingbot decydują o tym, czy sklep w ogóle pojawia się w wynikach wyszukiwania. Jeśli sklep sprzedaje także przez Google Merchant Center, Amazon czy porównywarki cen, ich roboty regularnie sprawdzają, czy ceny i dostępność w sklepie zgadzają się z danymi na marketplace'ie. Podobnie działają piksele reklamowe i narzędzia analityczne.
Obok nich jest ruch, który niczego sklepowi nie daje. Agresywne crawlery AI pobierają całe sklepy, żeby trenować modele językowe, scrapery kopiują opisy i ceny, a inne programy szukają luk w zabezpieczeniach. Dobra konfiguracja zaczyna się od rozdzielenia tych grup: robotów niezbędnych, przyjaznych, ale kosztownych, i takich, które tylko obciążają serwer.
Integracje, których nie wolno zablokować
Po włączeniu Cloudflare najczęściej przestają działać połączenia, które nie pochodzą z przeglądarki klienta. BaseLinker łączy się z plikiem integracyjnym w sklepie, żeby pobierać zamówienia i aktualizować stany magazynowe, a przez niego często działa też sprzedaż na Allegro. Ceneo i inne porównywarki pobierają ze sklepu plik z ofertą, Google Merchant Center sprawdza ceny i dostępność na stronach produktów, a integracje kurierskie, takie jak InPost, wymieniają ze sklepem dane o przesyłkach i punktach odbioru.
Osobną grupą są webhooki operatorów płatności, na przykład Przelewy24 i PayU. To przez nie sklep dowiaduje się, że klient zapłacił. Gdy zapora potraktuje takie zapytanie jak bota i odpowie wyzwaniem albo błędem, zamówienie zostaje w statusie oczekiwania na płatność, choć pieniądze dotarły na konto. Dlatego te połączenia wyłącza się z wyzwań i limitów zapytań regułami opartymi na adresach i ścieżkach integracji, a nie na samym nagłówku User-Agent, który łatwo podrobić. Po każdej zmianie reguł warto przejrzeć w panelu Cloudflare zdarzenia bezpieczeństwa i sprawdzić, czy wśród zablokowanych zapytań nie ma tych usług.
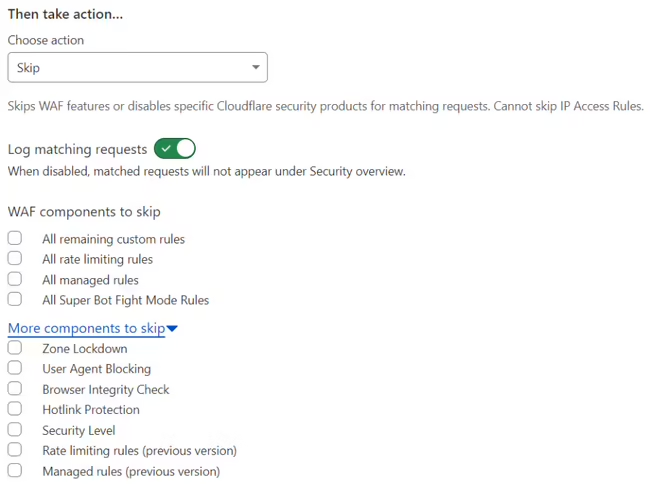
Które części sklepu najbardziej obciąża ruch automatyczny
W PrestaShop i w większości sklepów opartych na PHP najwięcej kosztują miejsca, w których serwer przy każdej odsłonie liczy coś od nowa: wyszukiwarka, filtry i nawigacja fasetowa, listy życzeń, porównywarki produktów i opinie. Crawler, który przechodzi przez wszystkie kombinacje filtrów, potrafi wygenerować więcej pracy niż setki klientów.
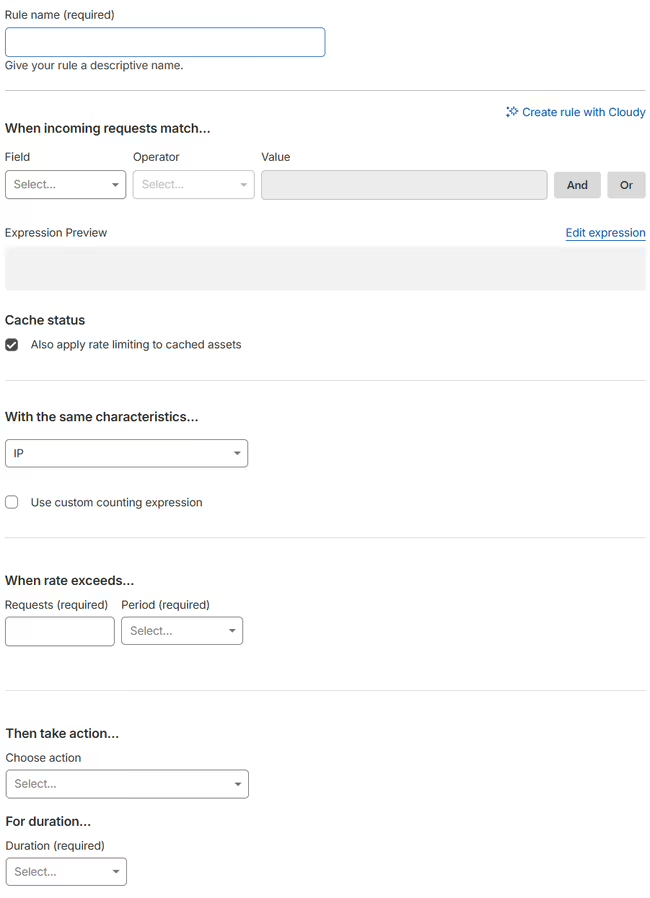
Do tego dochodzą zapytania wysyłane w tle przez moduły zewnętrzne, często przy każdej wczytanej stronie. Przy zwykłym ruchu nikt ich nie zauważa, ale gdy sklep odwiedza naraz kilka crawlerów, mnożą się razem z nimi. Jak takie obciążenie przekłada się na szybkość sklepu i wyniki w narzędziach pomiarowych, opisuje artykuł wolny sklep PrestaShop? Wynik Lighthouse to nie wszystko.
Ustawienia SEO pomagają, ale nie zatrzymają każdego crawlera
Właściwe znaczniki SEO i plik robots.txt to pierwszy krok. Dzięki nim Googlebot czy Bingbot nie odwiedzają tysięcy bezwartościowych adresów z filtrów i sortowań, co oszczędza serwer i nie wyczerpuje budżetu indeksowania, czyli liczby stron, które wyszukiwarka jest gotowa odwiedzić.
Agresywnych crawlerów AI te ustawienia nie powstrzymają, bo część z nich ignoruje i znaczniki, i robots.txt. Takie przypadki widać w logach serwera, dlatego warto je regularnie przeglądać i reagować regułami oraz limitami w Cloudflare albo optymalizacją stron, które są odpytywane najczęściej.
Boty AI w Cloudflare: klasy Search, Agent i Training
W lipcu 2026 roku Cloudflare zastąpił pojedynczy przełącznik „Block AI bots” trzema klasami ruchu. Search to roboty, które indeksują stronę na potrzeby wyszukiwarek, także tych opartych na AI. Agent to asystenci AI odwiedzający stronę na polecenie konkretnego użytkownika, na przykład żeby porównać produkty. Training to crawlery zbierające treści do trenowania modeli. Od 15 września 2026 roku obowiązują nowe ustawienia domyślne: na stronach wyświetlających reklamy Cloudflare blokuje klasy Training i Agent w nowych domenach, w nowych witrynach dotychczasowych klientów i w strefach na planie Free. Jeśli w strefie nikt nigdy nie zapisał własnych preferencji dla botów AI, obowiązują właśnie te zasady domyślne.
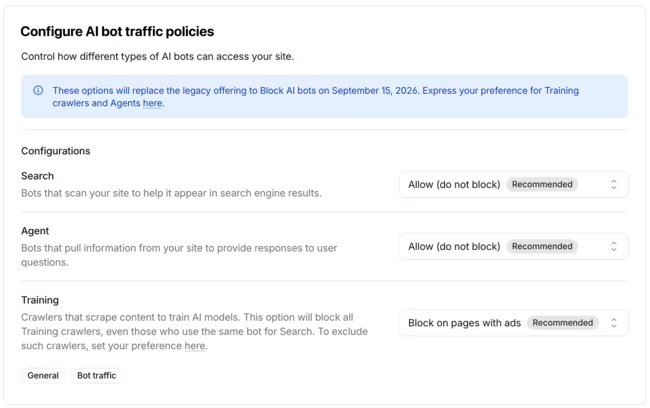
Sklepy rzadko wyświetlają reklamy, więc same ustawienia domyślne dotkną ich słabiej niż portale. Dużo groźniejsza jest pułapka przy ręcznej blokadzie klasy Training. Googlebot, Bingbot i Applebot obsługują jednocześnie wyszukiwanie i trenowanie modeli, a Cloudflare ocenia takie roboty według najbardziej restrykcyjnej reguły, która do nich pasuje. Blokada Training, również przez stary przełącznik „Block AI bots”, potrafi więc zatrzymać roboty wyszukiwarek: opisywano przypadki, w których Googlebot i Bingbot dostawały błąd 403 przy pobieraniu mapy witryny. Sklep, który chciał tylko chronić opisy produktów przed trenowaniem modeli, może stracić widoczność w Google. Bezpieczniej zapisać w ustawieniach świadomą decyzję dla każdej z trzech klas, dodać reguły wprost przepuszczające roboty wyszukiwarek i sprawdzić w logach serwera oraz w Google Search Console, czy nie pojawiły się błędy 403.
Zachowanie crawlerów się zmienia
Konfiguracji nie da się ustawić raz na zawsze. Zdarza się, że robot, który przez lata zachowywał się przewidywalnie, zaczyna generować nadmierny ruch i obciążać serwer. Ponowna analiza i korekta ustawień pozwalają wtedy wyważyć dwie sprawy. Z jednej strony serwer musi być chroniony, żeby strona nie zwracała błędów 500 z powodu przeciążenia. Z drugiej sklep musi pozostać dostępny dla wyszukiwarek, bo zbyt mocne ograniczenie ich robotów szybko odbija się na ruchu organicznym, a może też wyraźnie ograniczyć kampanie reklamowe oparte na danych produktowych. Taki przegląd ruchu i ustawień ochrony jest częścią audytu sklepu internetowego.
Profilaktyka a gaszenie pożaru
Gdy sklep właśnie przestaje działać pod naporem ruchu, liczy się szybkie zatrzymanie problemu, nawet kosztem tymczasowych ograniczeń. Przy profilaktyce można spokojnie przeanalizować ruch, przygotować reguły dopasowane do sklepu i sprawdzić, czy nie blokują płatności i integracji. Po gaszeniu pożaru powinna przyjść regularna weryfikacja konfiguracji z analizą logów dostępu, bo tymczasowe reguły mają tendencję do zostawania na lata.
Czy darmowy plan wystarczy
Dla większości prostych sklepów i aplikacji internetowych opartych na PHP darmowy plan Cloudflare wystarcza, pod warunkiem że jest dobrze skonfigurowany. Trzeba jednak wiedzieć, że zestaw reguł OWASP Core Ruleset, chroniący przed najczęstszymi typami ataków na aplikacje, Cloudflare udostępnia dopiero w płatnych planach. Dlatego przy darmowym planie często zaleca się dodatkowo włączyć po stronie serwera zaporę aplikacyjną, na przykład ModSecurity dla Apache. Płatne plany i usługi innych dostawców mają sens przy większym ruchu albo bardziej złożonych wymaganiach.
Wniosek
Każdy sklep i każda aplikacja internetowa wymagają konfiguracji Cloudflare dopasowanej do hostingu, bramek płatności i integracji, bo właśnie one najczęściej przestają działać po włączeniu niektórych funkcji. Równie ważna jest regularna obserwacja ruchu, żeby ochrona nie zaszkodziła SEO, robotom wyszukiwarek ani marketplace'om, które korzystają z danych pobieranych ze sklepu.
Często zadawane pytania: Cloudflare
Czy wystarczy aktywować Cloudflare, żeby boty przestały przychodzić?
Nie. Przekierowanie domeny na Cloudflare daje sieć dostarczania treści oraz ochronę przed najprostszymi atakami, lecz ruch wyglądający jak zwyczajne odwiedziny wciąż dociera do serwera sklepu. Należy włączyć właściwe reguły i ustawienia zapory, a także przygotować sklep tak, aby jego zasoby mogły trafiać do pamięci podręcznej. Część funkcji niesie skutki uboczne, choćby problemy z płatnościami lub integracjami. Konfiguracja wygląda też inaczej wtedy, gdy sklep zmaga się już z nadmiernym ruchem i trzeba reagować natychmiast, a inaczej przy działaniach profilaktycznych.
Po wdrożeniu Cloudflare nie widzę zmian wprowadzanych na stronie. Z czego to wynika?
Zmiany mogą być zatrzymywane w dwóch miejscach: w pamięci podręcznej przeglądarki oraz w pamięci podręcznej Cloudflare. Na czas prac można włączyć w Cloudflare tryb deweloperski, który tymczasowo omija pamięć podręczną. Przy poprawnej konfiguracji sklepu i motywu, w tym wersjonowaniu plików CSS i JavaScript, problem w ogóle nie powinien występować, bo każda zmiana dostaje nowy adres pliku. Sprawdzenie tej konfiguracji jest częścią usług audytowych BeGiga.
Czy mogę po prostu zablokować wszystkie boty?
Nie bez strat. Część botów jest potrzebna do widoczności w wyszukiwarce, część do integracji z marketplace'ami i usługami reklamowymi. Zbyt agresywne ustawienia mogą zablokować roboty Google albo zerwać integracje, z których sklep czerpie sprzedaż.
- Cloudflare
- Crawlery AI
- Ruch automatyczny
- PrestaShop
- SEO