Lokalny model językowy w firmie: jaki sprzęt do jakiego modelu
Lokalny LLM do dokumentów firmy: dlaczego liczy się VRAM karty graficznej, jakie modele wybrać, kiedy wystarczy VPS i czego wymaga trening.
Firmy, które uporządkowały dokumenty w archiwum takim jak Paperless-ngx, szybko dochodzą do kolejnego pytania: czy model językowy, który ma te dokumenty czytać, może działać na własnym sprzęcie. Może, a to, jaki sprzęt kupić, zależy od tego, jaki model jest potrzebny i do czego.
Lokalny LLM nie musi dorównywać największym modelom w chmurze. Do opisywania dokumentów, wyciągania dat i kontrahentów czy odpowiadania na pytania o treść archiwum często wystarcza model średniej wielkości, a dane nie opuszczają firmy.
Najważniejsza jest pamięć karty graficznej
O tym, jaki model da się uruchomić, decyduje przede wszystkim pamięć karty graficznej, czyli VRAM. Model działa sprawnie tylko wtedy, gdy jego wagi mieszczą się w tej pamięci w całości. Jeśli się nie mieszczą, część trafia do zwykłej pamięci RAM i odpowiedzi wielokrotnie zwalniają. Moc obliczeniowa karty też ma znaczenie, ale to brak pamięci najczęściej wyklucza dany model.
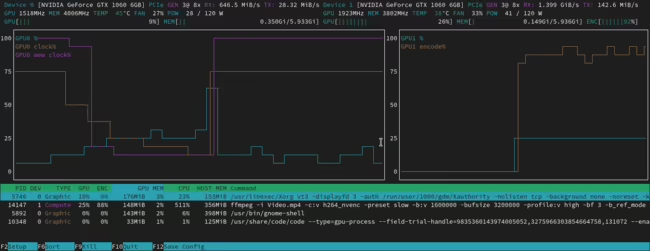
Ilość potrzebnej pamięci zmniejsza kwantyzacja, czyli zapis wag z mniejszą precyzją. Na oko model w kwantyzacji 4-bitowej zajmuje nieco ponad pół gigabajta na każdy miliard parametrów, więc model 8B potrzebuje około 5 GB, a model 32B około 20 GB. Trzeba do tego doliczyć pamięć na kontekst, czyli tekst, który model ma jednocześnie przed sobą, oraz na równoległe zapytania kilku użytkowników. Długie dokumenty i kilka osób pytających naraz potrafią zająć tyle pamięci, co sam model.
Jakie modele uruchamia się lokalnie
Modele z otwartymi wagami wydaje dziś kilku dużych producentów. Najczęściej spotyka się rodziny Llama od Meta, Qwen od Alibaby, Mistral, Gemma od Google, gpt-oss od OpenAI i DeepSeek. Przy dokumentach po polsku warto przetestować też modele rozwijane w Polsce, takie jak Bielik czy PLLuM, trenowane z większym udziałem polskich tekstów. Każda rodzina ma kilka rozmiarów, a licencje różnią się warunkami użycia komercyjnego, więc przed wdrożeniem trzeba je sprawdzić.
W praktyce rozmiary dzielą się na trzy grupy. Małe modele, do kilku miliardów parametrów, dobrze radzą sobie z klasyfikacją, tagowaniem i wyciąganiem pojedynczych pól z dokumentów. Modele średnie, od kilkunastu do kilkudziesięciu miliardów parametrów, odpowiadają na pytania o treść dokumentów i przygotowują zestawienia na poziomie, który w większości firmowych zastosowań wystarcza. Największe modele zbliżają się jakością do usług chmurowych, ale wymagają kilku kart graficznych albo serwera z bardzo dużą pamięcią.
System pracy z dokumentami potrzebuje zwykle więcej niż jednego modelu. Model embeddingowy zamienia fragmenty dokumentów na wektory do wyszukiwania i jest na tyle mały, że działa obok głównego modelu bez osobnego sprzętu. Przy skanach słabej jakości, tabelach i piśmie odręcznym dochodzą modele wizyjne, które czytają dokument jako obraz i często radzą sobie lepiej niż klasyczne OCR.
Od komputera biurowego do serwera z kartami graficznymi
Sprzęt dobiera się do modelu i liczby użytkowników, nie odwrotnie. Komputer albo mały serwer z jedną kartą konsumencką o 8–16 GB VRAM wystarcza dla małych modeli i pojedynczych użytkowników, na przykład do automatycznego opisywania dokumentów w Paperless-ngx. Stacja robocza z kartą 24–32 GB albo dwiema kartami obsłuży modele średnie i niewielki zespół. Większe modele, wielu użytkowników naraz i długie dokumenty wymagają serwera z kartami przeznaczonymi do centrów danych.
Inną drogą są komputery Apple z procesorami serii M, w których procesor i układ graficzny korzystają ze wspólnej pamięci. Ta pamięć może sięgać nawet kilkuset gigabajtów, więc mieszczą się w niej duże modele, ale odpowiedzi generują się wolniej niż na najmocniejszych kartach, a wielu użytkowników naraz obciąża je wyraźniej. Przy wyborze liczy się też RAM i dysk: pojedynczy model zajmuje od kilku do kilkuset gigabajtów, a w firmie zwykle trzyma się ich kilka, żeby porównywać wyniki.
Czy lokalny model może działać na VPS
Tak. Dostawcy chmury i hostingu oferują serwery wirtualne z kartami graficznymi, także w centrach danych w Unii Europejskiej. Model działa wtedy na infrastrukturze wynajmowanej przez firmę, a nie u dostawcy AI, a dostęp można ograniczyć do sieci prywatnej albo VPN, tak samo jak przy archiwum dokumentów. To wygodny sposób na start i na testy, zanim firma zdecyduje się na własny sprzęt. Zwykły VPS bez karty graficznej uruchomi tylko mały model i obsłuży pojedyncze zapytania, więc nadaje się raczej do zadań w tle niż do rozmowy z archiwum.
Dostęp do lokalnego serwera spoza biura
Serwer z modelem zwykle stoi w biurze albo w serwerowni, a pracownicy chcą z niego korzystać także z domu czy w podróży. Bezpieczny dostęp spoza biura daje się zbudować na dwa sposoby: przez prywatną sieć VPN albo przez tunel do zaufanego pośrednika. W obu przypadkach serwer nie musi być widoczny z internetu.
Pierwszy sposób to sieć prywatna typu VPN, w której serwer i urządzenia pracowników łączą się szyfrowanym tunelem. Można ją zbudować na WireGuard, na przykład na niewielkim serwerze VPS, albo skorzystać z gotowej usługi opartej na tym protokole, takiej jak Tailscale. Gdy model działa na serwerach w chmurze, na przykład w Hetznerze, serwery łączy się siecią prywatną dostawcy, a do internetu wystawia się tylko bramę VPN. Drugi sposób to tunel, w którym serwer sam nawiązuje połączenie wychodzące do pośrednika, więc nie trzeba otwierać żadnych portów. Tak działa Cloudflare Tunnel, zwykle w parze z Cloudflare Access, które przed wpuszczeniem do aplikacji wymaga logowania firmowym kontem.
Wybór zależy od tego, jak wrażliwe są dane. W tunelu Cloudflare ruch jest odszyfrowywany na serwerach pośrednika, zanim trafi do firmy. Przy dokumentach, które nie powinny opuszczać firmy nawet na chwilę, lepiej sprawdza się VPN, w którym szyfrowanie obejmuje całą drogę od urządzenia pracownika do serwera. Otwarcie portu na routerze i wystawienie serwera pod publicznym adresem IP to w większości przypadków kiepski pomysł. API Ollamy domyślnie nie wymaga logowania, więc każdy, kto znajdzie taki adres, może korzystać z modelu, obciążać serwer, a przy podłączonym archiwum także próbować dostać się do dokumentów. O bezpieczeństwie decyduje konfiguracja: kto ma dostęp, jak odbiera się go osobom odchodzącym z firmy i czy serwer jest regularnie aktualizowany. To element, który BeGiga przygotowuje razem z samym serwerem i modelem w ramach usługi wdrożeń AI i analizy dokumentów.
Trening, dostrajanie i ewaluacja to różne wymagania
Uruchamianie modelu, czyli inferencja, to najlżejsze z tych zadań. Ewaluacja opiera się na tym samym: model odpowiada na przygotowany zestaw pytań, a odpowiedzi porównuje się z oczekiwanymi. Wystarcza do niej sprzęt, na którym model ma pracować na co dzień, choć przy dużych zestawach testowych przydaje się karta obsługująca wiele zapytań równolegle.
Trenowanie i dostrajanie wymagają znacznie więcej. Oprócz wag w pamięci muszą się zmieścić gradienty i stany optymalizatora, przez co pełne dostrajanie potrzebuje kilka razy więcej pamięci niż inferencja tego samego modelu. Metody takie jak LoRA i QLoRA zmniejszają ten narzut na tyle, że mniejszy model da się dostroić na jednej mocnej karcie, ale modele średnie i duże nadal wymagają serwerów z kilkoma kartami. Rozsądnym podejściem bywa wynajęcie mocniejszej maszyny wyłącznie na potrzeby treningu i uruchamianie gotowego modelu na własnym, skromniejszym sprzęcie. W projektach z dokumentami trening często w ogóle nie jest potrzebny, bo gotowy model połączony z archiwum przez RAG daje wystarczające wyniki.
Oprogramowanie do uruchamiania modeli
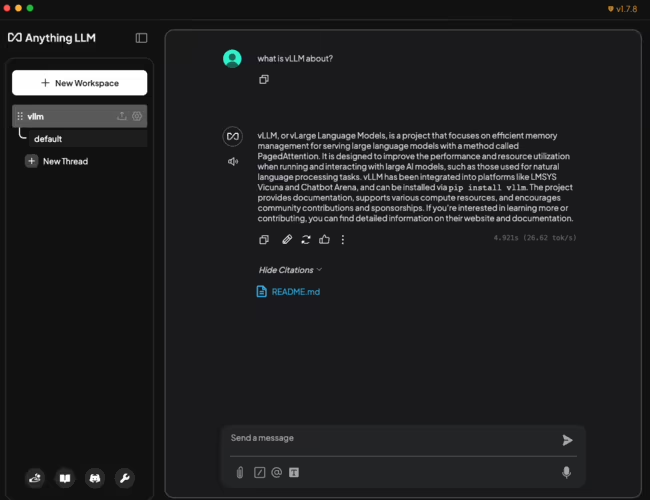
Ollama najprościej uruchamia modele na jednym serwerze i ma gotowe połączenia z wieloma narzędziami, między innymi z Paperless-AI, rozszerzeniem, które dodaje do Paperless-ngx opisywanie dokumentów i rozmowę z archiwum przez model językowy. llama.cpp działa także na samym procesorze i obsługuje modele skwantyzowane w formacie GGUF. vLLM sprawdza się tam, gdzie z modelu korzysta jednocześnie wiele osób albo aplikacji, bo lepiej wykorzystuje kartę przy równoległych zapytaniach. Większość tych narzędzi udostępnia interfejs zgodny z API OpenAI, więc aplikację można przełączyć z modelu w chmurze na lokalny bez przepisywania.
Od czego zacząć wdrożenie lokalnego LLM
Zanim firma kupi sprzęt, dobrze określić zadania: czy model ma tylko opisywać dokumenty w tle, odpowiadać pracownikom na pytania, czy przygotowywać nowe dokumenty. Potem warto sprawdzić kilka modeli na własnych dokumentach, najlepiej na wynajętym serwerze, i porównać jakość odpowiedzi na zestawie typowych pytań. Dopiero wtedy wiadomo, który rozmiar modelu wystarcza i jaki sprzęt go udźwignie. BeGiga projektuje takie serwery, dobiera karty graficzne i lokalne modele oraz łączy je z archiwum dokumentów w ramach usługi wdrożeń AI i analizy dokumentów.
Często zadawane pytania: Lokalny LLM
Czy lokalny model językowy zadziała bez karty graficznej?
Mały model da się uruchomić na samym procesorze i pamięci RAM, na przykład przez llama.cpp albo Ollamę. Odpowiedzi pojawiają się jednak wyraźnie wolniej niż na karcie graficznej, a przy kilku użytkownikach naraz serwer szybko przestaje nadążać. Do opisywania dokumentów w tle to bywa wystarczające, do rozmowy z archiwum zwykle już nie.
Ile pamięci VRAM potrzeba do lokalnego LLM?
Na oko model w kwantyzacji 4-bitowej zajmuje nieco ponad pół gigabajta na każdy miliard parametrów, a do tego dochodzi pamięć na kontekst i równoległe zapytania. Model kilkumiliardowy zmieści się na karcie z 8–12 GB, modele średnie potrzebują 24 GB lub więcej, a największe kilku kart albo serwera z bardzo dużą pamięcią.
Czy do pracy z dokumentami firmy trzeba trenować własny model?
Najczęściej nie. W większości projektów wystarcza gotowy model połączony z uporządkowanym archiwum przez RAG, czyli wyszukiwanie fragmentów dokumentów i podawanie ich modelowi razem z pytaniem. Dostrajanie ma sens przy bardzo specyficznym języku albo formacie odpowiedzi i wymaga mocniejszego sprzętu niż samo uruchamianie modelu.
- Lokalny LLM
- VRAM
- Ollama
- Paperless-AI
- RAG