Zanim przedsiębiorstwo sięgnie po AI, musi mieć porządek w dokumentach: archiwum Paperless-ngx na start
Archiwum Paperless-ngx porządkuje e-maile, skany i faktury, chroni prywatność i przygotowuje dane pod AI. Gdzie są jego granice i kiedy wybrać inny system.
Niejedna firma chętnie wykorzystałaby AI: po to, by prędzej docierać do informacji, tworzyć raporty, reagować na pytania klientów. Podstawą jest jednak to, że AI musi mieć dostęp do danych. Tymczasem w wielu przedsiębiorstwach pewna część dokumentów wciąż funkcjonuje wyłącznie w formie papierowej bądź jako porozrzucane pliki, a znaczna ich część nigdy nie ląduje w jednym uporządkowanym miejscu.
Dlatego krokiem otwierającym bywa firmowe archiwum dokumentów. Budowanie wewnętrznej bazy wiedzy oraz narzędzi AI, które z niej czerpią, możliwe jest dopiero na takiej podstawie.
Otwarte systemy do zarządzania dokumentami
Przykład takiego archiwum to Paperless-ngx, znany system open source służący zarządzaniu dokumentami i ich archiwizacji. Identyczne reguły odnoszą się zresztą do pozostałych otwartych narzędzi tego rodzaju. Jedno z nich to Mayan EDMS, rozbudowany system z obiegiem dokumentów, ukierunkowany na większe organizacje.
W dużych firmach dokumentami zajmuje się zazwyczaj oprogramowanie powiązane z systemami klasy ERP i CRM, takimi jak SAP, Comarch, Asseco czy Salesforce, a także środowiska pracy biurowej i zarządzania kontami użytkowników, na przykład Microsoft 365 z Entra ID (dawniej Azure Active Directory) albo Google Workspace. Minusem takich rozwiązań pozostaje silna zależność od dostawcy: zmiany i integracje wymagają współpracy z nim i podlegają jego ograniczeniom. Paperless-ngx wyróżnia się na tym tle prostotą codziennej pracy i dużą społecznością, dzięki czemu dobrze nadaje się na start w małej firmie.
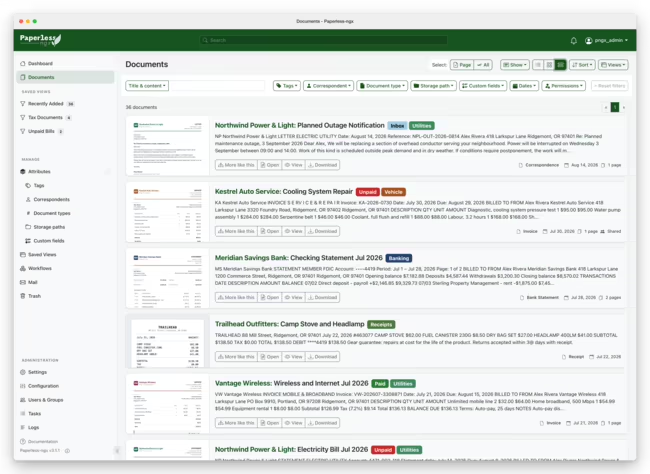
Dlaczego AI i wewnętrzna baza wiedzy zaczynają się od dokumentów
Księgowość i rozliczenia nawet w najmniejszych firmach zwykle są już prowadzone w systemach księgowych. Przy digitalizacji najczęściej porzucane są dokumenty pomocnicze: raporty, sprawozdania, robocze zestawienia, notatki i protokoły z pracy w terenie. Nikt nie ma czasu ich porządkować, a szuka się ich z trudem dopiero wtedy, gdy są potrzebne. To w nich kryje się jednak duża część wiedzy firmy, z której mogłoby korzystać AI.
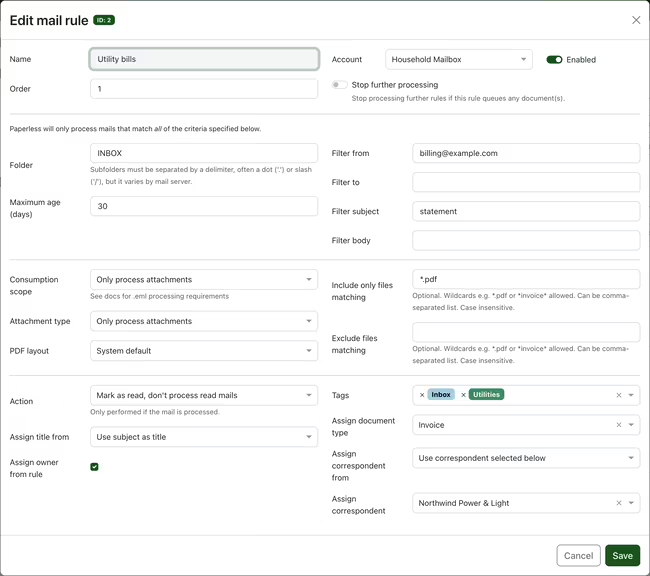
Dobrym przykładem nieuporządkowanego źródła wiedzy jest poczta e-mail. To w niej zapisana jest historia współpracy z kontrahentami, z sukcesami i trudnościami, ale rzadko ktoś sortuje ręcznie każdy mail i każdy załącznik, zwłaszcza gdy wśród załączników są ikony ze stopek i duplikaty tych samych plików. Archiwum potrafi to zrobić: pobrać załączniki, pominąć zbędne i przypisać resztę do właściwych kategorii. Ma to znaczenie także dla prywatności. Wiele firm rezygnuje z automatycznego porządkowania poczty w zewnętrznych usługach, bo nie wie, gdzie są przetwarzane dane, a przekazanie korespondencji zewnętrznemu narzędziu może grozić wyciekiem danych kontrahentów.
Do czego można wykorzystać system archiwizacji dokumentów
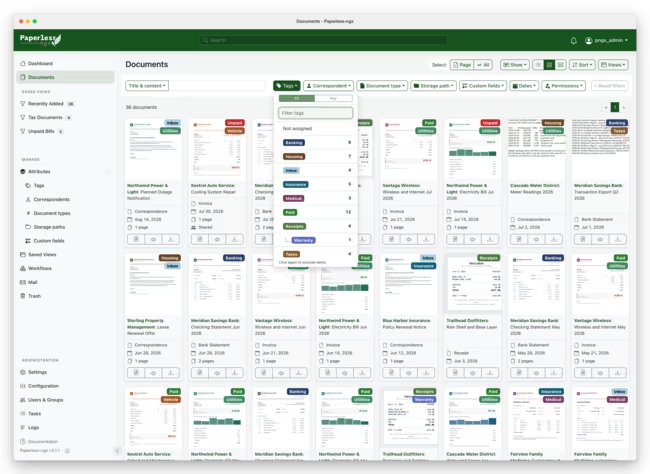
Każdy dokument, zeskanowany albo elektroniczny, przechodzi przez rozpoznawanie tekstu (OCR), dzięki czemu można go odnaleźć po dowolnym słowie z treści. Z pismem odręcznym radzi sobie gorzej niż z drukiem, choć połączenie archiwum z modelami AI poprawia wyniki. System przypisuje dokumentom typ, kontrahenta i tagi, ucząc się na tym, jak były opisywane wcześniej, a rozszerzenia oparte na modelach językowych potrafią zaproponować także tytuł, ścieżkę zapisu i daty. Automatyczne tagowanie to jedna z największych zalet takiego archiwum, bo z czasem większość dokumentów jest opisywana bez udziału człowieka.
Archiwum pomaga też uporządkować kopie papierowe. Każdy fizyczny dokument może dostać numer archiwalny w postaci kodu kreskowego albo kodu QR, który system odczytuje przy skanowaniu, więc wiadomo, w którym segregatorze leży oryginał.
Od początku warto jednak określić własne cele: jakie dokumenty mają trafiać do archiwum, po czym będą wyszukiwane, kto będzie z nich korzystał i w jakim celu. Standardowa instalacja to dopiero punkt wyjścia. Po kilku tygodniach używania warto wrócić do ustawień, poprawić reguły i dopasować archiwum do tego, jak faktycznie pracuje firma.
Prywatność i RODO
Archiwum dokumentów jest przeznaczone dla danych prywatnych i poufnych, dlatego miejsce jego działania ma duże znaczenie. Pliki mogą być przechowywane w sieci prywatnej, na komputerze lub serwerze w firmie, z dostępem z zewnątrz przez tunel. Jeśli ważniejsza jest wygoda, archiwum może działać na prywatnym serwerze VPS z siecią prywatną. W obu przypadkach pliki nie są dostępne publicznie, a sposób przechowywania i dostępu można dopasować do wymagań RODO obowiązujących w firmie.
Trzeba przy tym wiedzieć, że Paperless-ngx przechowuje pliki bez szyfrowania na poziomie aplikacji. Szyfrowanie zapewnia się warstwę niżej: szyfrowanym dyskiem lub wolumenem, szyfrowanymi kopiami zapasowymi trzymanymi poza serwerem i ograniczonym dostępem do samej maszyny. To etap, na którym jedno przeoczenie, choćby niezaszyfrowana kopia na zewnętrznym dysku, przekreśla resztę zabezpieczeń, więc dobrze, żeby zajmował się nim ktoś, kto zna zarówno Paperless-ngx, jak i administrację serwerami. Jeśli priorytetem są rozbudowane uprawnienia albo obieg dokumentów z akceptacjami, trzeba do tego dobrać odpowiednią technologię. Takie wdrożenia, łącznie z doborem sprzętu i lokalnych modeli AI, BeGiga realizuje w ramach usługi archiwum dokumentów i wdrożeń AI.
Ilu użytkowników i jakie uprawnienia
Przed wdrożeniem trzeba ustalić, ile osób będzie korzystać z archiwum i kto ma widzieć które dokumenty. Systemy różnią się tu stopniem zaawansowania. Paperless-ngx oferuje podstawowy model: każdy dokument ma właściciela, a prawo do oglądania lub edycji można nadać wybranym użytkownikom i grupom. Domyślna konfiguracja najlepiej odpowiada jednemu użytkownikowi. W zespole bez przemyślanych uprawnień łatwo o nieporządek, a dokumenty zaimportowane bez przypisanego właściciela mogą być widoczne dla wszystkich.
Kiedy lepszy będzie inny system
Uniwersalne archiwum nie zawsze pasuje do sposobu pracy firmy albo do oprogramowania, którego już używa. Firmy korzystające z SAP, rozbudowanych systemów ERP i CRM, środowiska Microsoft z SharePointem i Entra ID czy z Salesforce mają w tych systemach własne moduły do obsługi dokumentów i często lepiej rozwijać to, co już działa, bo integracja kolejnego systemu z wieloma istniejącymi bywa trudna i kosztowna. Rozwiązania open source dają za to elastyczność: można je modyfikować, rozbudowywać i dopasowywać do potrzeb firmy.
Archiwa dokumentów open source uruchamiane na własnym serwerze najlepiej sprawdzają się w firmach, które nie są obciążone takim oprogramowaniem, czyli w biurach usługowych i w małych firmach handlowych i produkcyjnych. Dokładna granica zależy od organizacji, ale zawsze warto jasno określić cel. Paperless-ngx pozwala udostępnić pojedynczy dokument linkiem, a jeśli archiwum działa za serwerem pośredniczącym z dodatkowym logowaniem, link zadziała publicznie dopiero po dodaniu wyjątku w tej warstwie, co wymaga ostrożności. Do publicznej wymiany dokumentów to narzędzie się nie nadaje. Pliki przechowuje bez szyfrowania na poziomie aplikacji, dlatego najlepiej traktować je jako archiwum w sieci lokalnej albo jako element budowania zbioru dokumentów do przyszłych projektów z modelami językowymi.
Jeśli potrzeby wykraczają poza możliwości takiego narzędzia, lepiej rozważyć ofertę związaną z używanym systemem ERP albo rozwiązania open source klasy enterprise, takie jak wspomniany Mayan EDMS.
Paperless-ngx a systemy DMS: DocuWare, M-Files, Filedoc i Mayan EDMS
W rozmowach o porządkowaniu dokumentów obok Paperless-ngx pojawiają się zwykle komercyjne systemy DMS, takie jak DocuWare, M-Files czy Filedoc, oraz otwarty Mayan EDMS. Wszystkie przechowują dokumenty, ale powstały do innych zadań. Systemy komercyjne prowadzą dokument przez cały jego cykl w organizacji: akceptacje, wersje, podpis elektroniczny, integracje z ERP i wymogi audytowe, z umową licencyjną i wsparciem producenta. Paperless-ngx robi mniej. Zbiera dokumenty z poczty, skanera i folderów, rozpoznaje tekst, opisuje je i udostępnia przez API, a pliki zostają na dysku w czytelnej strukturze.
To ostatnie ma duże znaczenie w projektach AI. Archiwum z tagami, typami dokumentów i kontrahentami jest gotowym zbiorem danych: dokumenty mają już tekst po OCR i metadane, które w systemie RAG służą do filtrowania wyników, na przykład do zawężenia odpowiedzi do umów jednego kontrahenta. Na takim zbiorze buduje się potoki w LangChain, agentów AI w LangGraph, którzy przeszukują archiwum, porównują dokumenty i przygotowują zestawienia, a także ewaluację sprawdzającą, czy odpowiedzi opierają się na właściwych dokumentach. Paperless-ngx staje się wtedy warstwą danych pod narzędzia AI, a decyzja o systemie obiegu dokumentów może zapaść później, kiedy będzie jasne, czy firma potrzebuje akceptacji i podpisów, czy przede wszystkim dostępu do wiedzy zapisanej w dokumentach.
| System | Główne zastosowanie | Obieg z akceptacjami | Model wdrożenia | Rola w projektach AI |
|---|---|---|---|---|
| Paperless-ngx | Archiwum: OCR, automatyczne opisywanie, wyszukiwanie | Nie, tylko reguły automatycznego opisywania | Open source, własny serwer lub VPS | Źródło tekstu i metadanych dla RAG i agentów, dostęp przez API |
| Mayan EDMS | Archiwum z obiegiem dokumentów i rozbudowanymi uprawnieniami | Tak | Open source, własny serwer | Źródło danych, wymaga więcej konfiguracji |
| DocuWare | Zarządzanie dokumentami i procesami w firmie | Tak | Komercyjny, chmura lub instalacja lokalna | Funkcje AI producenta w ramach platformy |
| M-Files | Zarządzanie dokumentami oparte na metadanych | Tak | Komercyjny, chmura lub instalacja lokalna | Funkcje AI producenta w ramach platformy |
| Filedoc | Zarządzanie dokumentami, workflow bez programowania, podpis elektroniczny | Tak | Komercyjny, chmura lub instalacja lokalna | Inteligentne przetwarzanie dokumentów producenta |
Co umożliwia uporządkowane archiwum
Archiwizacja i dobra kategoryzacja dokumentów otwierają drogę do wewnętrznych narzędzi AI. Na takim archiwum mogą działać wewnętrzne chatboty, które odpowiadają na pytania o treść dokumentów i wskazują źródło, integracje z lokalnymi modelami językowymi pomagające tworzyć kolejne dokumenty i raporty, zapytania obejmujące wiele dokumentów naraz czy wyszukiwanie niespójności między umowami, fakturami i protokołami. W odróżnieniu od chatbota na stronie internetowej, który korzysta z treści publicznych, takie narzędzia pracują na danych wewnętrznych. Technicznie opierają się na wektorowym indeksie dokumentów i podejściu RAG, ale bez uporządkowanego archiwum nie mają z czego korzystać.
Rozszerzenia takie jak Paperless-AI łączą archiwum z modelem językowym uruchomionym lokalnie, na przykład przez Ollamę, więc dokumenty nie opuszczają firmy także na etapie analizy. Jaki sprzęt jest do tego potrzebny i jak dobrać model, opisuje artykuł lokalny model językowy w firmie.
Od czego zacząć porządkowanie dokumentów
Najlepiej zacząć od pytania, które dokumenty sprawiają w firmie najwięcej kłopotu i co najbardziej utrudnia ich digitalizację. Czasem lukę wypełnia gotowa funkcja albo istniejący dodatek, a czasem potrzebny jest stos narzędzi dopasowany do konkretnego sposobu pracy.
Często zadawane pytania: Paperless-ngx
Czy dokumenty z archiwum trafią do zewnętrznej chmury?
Nie muszą. Archiwum może działać na komputerze lub serwerze w firmie, w sieci prywatnej, albo na prywatnym serwerze VPS z siecią prywatną. W obu przypadkach pliki nie są dostępne publicznie, a dostęp z zewnątrz może prowadzić przez tunel lub VPN.
Czy Paperless-ngx nadaje się do wymiany dokumentów z kontrahentami?
Raczej nie. Linki do udostępniania obejmują pojedyncze dokumenty, a nie całe foldery czy grupy dokumentów, a same pliki są przechowywane bez szyfrowania na poziomie aplikacji. Narzędzie lepiej sprawdza się jako firmowe archiwum w sieci lokalnej niż jako kanał wymiany dokumentów między firmami.
Czy archiwum może samo pobierać dokumenty z poczty?
Tak. Paperless-ngx potrafi łączyć się ze skrzynkami pocztowymi, pobierać załączniki według ustalonych reguł i od razu je opisywać, co oszczędza ręcznego zapisywania plików z maili.
- Paperless-ngx
- Archiwum dokumentów
- Digitalizacja
- Lokalne AI
- RODO